Từ Dữ Liệu Thô Đến Lớp Rủi Ro: Bí Quyết Chuyên Nghiệp Trong Credit Scoring
AI Summary
MỤC LỤC
- Mở đầu: Chuyện nhỏ nhưng “sống còn” trong mô hình tín dụng
- Tại sao phân loại dữ liệu lại quan trọng trong mô hình tín dụng?
- Các phương pháp phân loại dữ liệu phổ biến và ứng dụng thực tế
- 1. Phân chia theo khoảng đều (Equal-Interval Binning)
- 2. Chia theo tần suất đều (Equal-Frequency Binning)
- 3. Phân nhóm dựa trên Chi-square (Chi-square Binning)
- 4. WoE-based grouping
- Truyền cảm hứng từ thực tiễn: Làm thế nào để discretize dữ liệu hiệu quả?
- Góc nhìn cá nhân: Chọn cách phân loại phù hợp để nâng cao chất lượng mô hình
Mở đầu: Chuyện nhỏ nhưng “sống còn” trong mô hình tín dụng
Bạn có từng nghĩ rằng, mô hình dự báo rủi ro tín dụng của ngân hàng hoặc công ty tài chính có thể thất bại không phải vì thuật toán yếu kém, mà do cách xử lý dữ liệu ban đầu chưa đúng? Thực tế, có rất nhiều trường hợp mô hình “ngốn” dữ liệu, hàng loạt biến số được đưa vào, nhưng kết quả vẫn chệch hướng. Lý do? Bởi vì dữ liệu thô chưa được chuẩn bị tốt để mô hình có thể hiểu và khai thác một cách tối ưu.
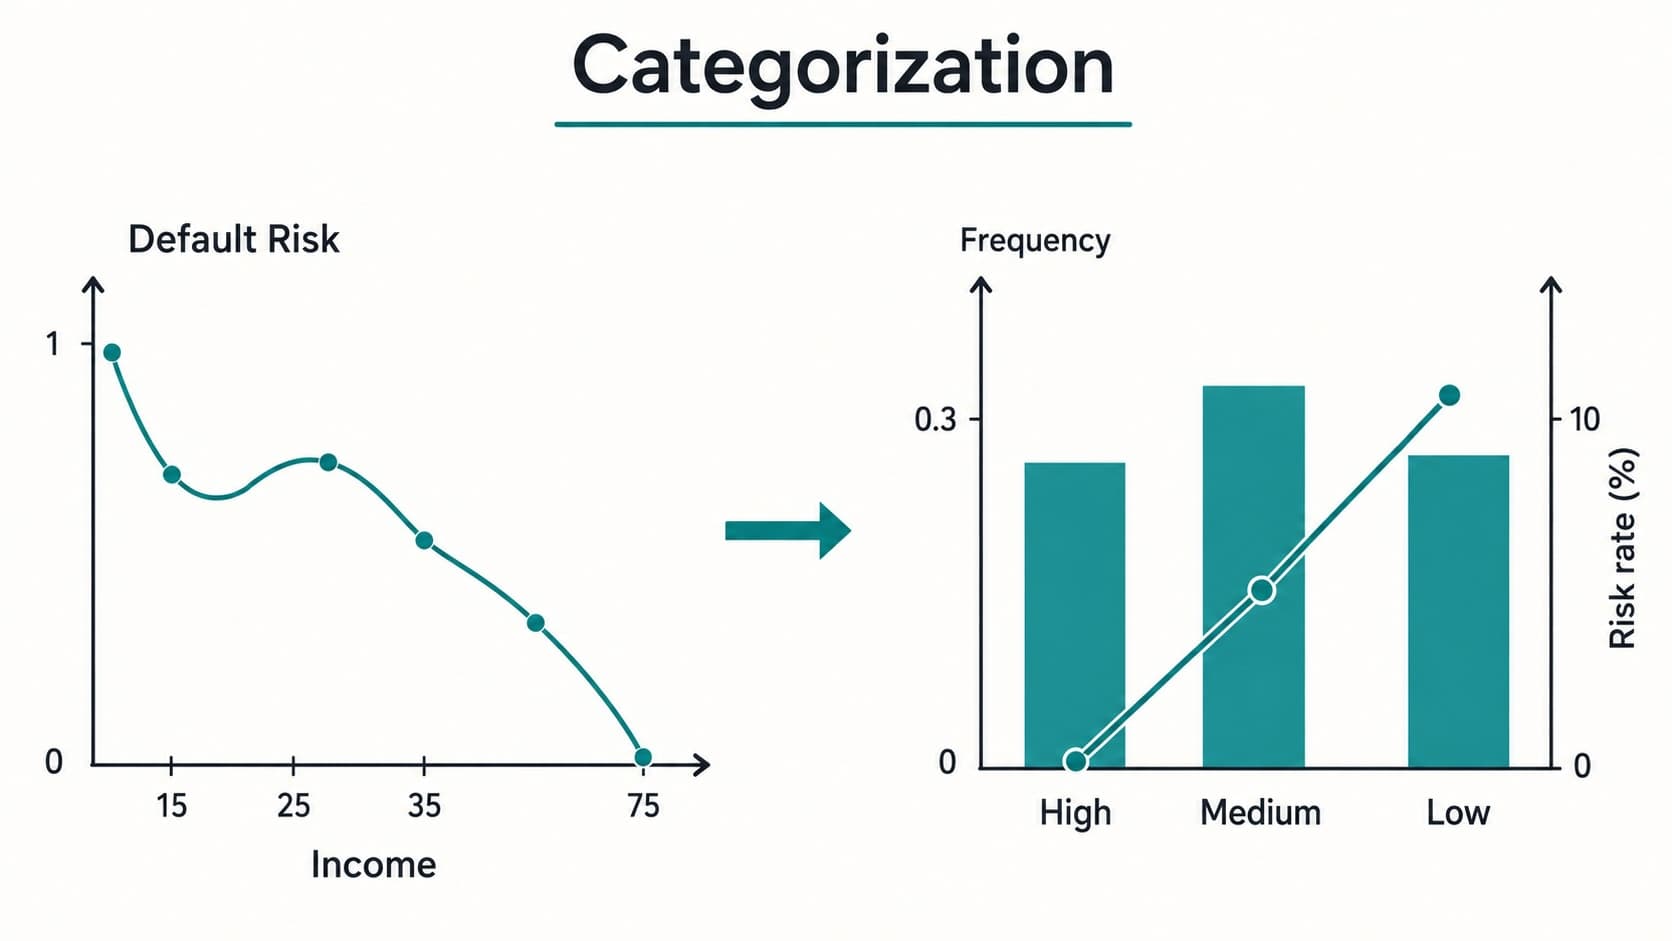
Trong thế giới của credit scoring, dữ liệu không đơn thuần là những con số khô khan. Nó mang theo các đặc điểm phức tạp như quan hệ phi tuyến, các outliers, missing values, hoặc các phân phối không ổn định. Và đây chính là lý do tại sao bước phân loại dữ liệu (categorization) lại đóng vai trò then chốt. Nó giúp biến dữ liệu “lộn xộn” thành những nhóm rõ ràng, dễ hiểu, dễ xử lý hơn.
Tại sao phân loại dữ liệu lại quan trọng trong mô hình tín dụng?
Trước khi đi sâu vào các kỹ thuật, ta cần hiểu rõ lý do vì sao phân loại dữ liệu lại quan trọng. Thứ nhất, đối với các biến số liên tục như thu nhập, số lần vay, hoặc số dư tài khoản, mối liên hệ với rủi ro không phải lúc nào cũng tuyến tính. Thứ hai, với các biến phân loại (categorical) như ngành nghề, tình trạng hôn nhân, hoặc khu vực địa lý, việc giữ nguyên các modality (đặc điểm) quá nhiều sẽ khiến mô hình trở nên phức tạp, khó interpret.
Trong mô hình logistic regression, việc biến các biến thô thành nhóm giúp giảm thiểu tác động của outliers, xử lý missing values dễ dàng hơn, đồng thời nâng cao khả năng giải thích kết quả. Đặc biệt, khi kết hợp với phương pháp Weight of Evidence (WoE), phân loại trở thành bước tiền xử lý cực kỳ hiệu quả để tạo ra các biến có tính ổn định cao, dễ theo dõi.
Các phương pháp phân loại dữ liệu phổ biến và ứng dụng thực tế
Có nhiều kỹ thuật phân loại dữ liệu, mỗi phương pháp phù hợp với từng loại biến và mục tiêu cụ thể. Dưới đây là một số phương pháp phổ biến và cách áp dụng thực tế:
1. Phân chia theo khoảng đều (Equal-Interval Binning)
Phương pháp này chia dữ liệu thành các khoảng có độ dài bằng nhau. Ví dụ, thu nhập từ 0 đến 10 triệu chia thành 5 khoảng: 0-2, 2-4, 4-6, 6-8, 8-10 triệu.
2. Chia theo tần suất đều (Equal-Frequency Binning)
Dữ liệu được phân chia thành các nhóm có số lượng dữ liệu như nhau. Ví dụ, trong 1000 khách hàng, chia thành 4 nhóm mỗi nhóm 250 người dựa trên thu nhập.
3. Phân nhóm dựa trên Chi-square (Chi-square Binning)
Đây là kỹ thuật phức tạp hơn, dựa trên phép kiểm định Chi-square để nhóm các modality có mối liên hệ chặt chẽ với mục tiêu (ví dụ: vỡ nợ hay không). Phương pháp này tối ưu hơn trong việc giữ lại các thông tin liên quan đến rủi ro.
4. WoE-based grouping
Đây là bước cuối cùng và đặc biệt phổ biến trong credit scoring. Các nhóm được xây dựng dựa trên Weight of Evidence, giúp biến đổi dữ liệu thành các biến mang tính giải thích cao, dễ dùng trong mô hình logistic.
Truyền cảm hứng từ thực tiễn: Làm thế nào để discretize dữ liệu hiệu quả?
Trong thực tế, việc discretize dữ liệu không đơn giản chỉ là chia đều hay theo tần suất. Nó đòi hỏi sự hiểu biết sâu về dữ liệu, mục tiêu dự án, và khả năng đánh giá ảnh hưởng của các nhóm sau phân loại.
Ví dụ, khi xử lý một biến liên tục như tuổi của khách hàng, không phải cứ chia đều là tốt. Thay vào đó, ta cần phân tích mối liên hệ của tuổi với khả năng vỡ nợ qua các biểu đồ monotonic, từ đó xác định các ngưỡng phù hợp như: 20-30, 30-40, 40-50, 50 trở lên.
Trong code, ta có thể dùng các thư viện như pandas hoặc sklearn để tạo các bin này, hoặc xây dựng thủ công dựa trên phân tích dữ liệu.
```python
import pandas as pd
import numpy as np
Giả sử có dữ liệu tuổi
ages = pd.Series([23, 45, 31, 52, 27, 38, 44, 60])
Chia theo equal-frequency
bins = pd.qcut(ages, q=4, labels=['Nhóm 1', 'Nhóm 2', 'Nhóm 3', 'Nhóm 4'])
print(bins)
```
Tóm lại, phân loại dữ liệu không chỉ là bước tiền xử lý, mà còn là nghệ thuật kết hợp phân tích, trực quan và kỹ thuật để tạo ra các biến ổn định, dễ hiểu, giúp mô hình dự báo chính xác hơn.
Góc nhìn cá nhân: Chọn cách phân loại phù hợp để nâng cao chất lượng mô hình
Trong môi trường làm việc của tôi, tôi nhận thấy rằng việc dành thời gian để phân tích, thử nghiệm các phương pháp phân loại phù hợp là bước quyết định thành bại của dự án. Không có một công thức chung nào cho tất cả, mà đòi hỏi sự linh hoạt, sáng tạo và hiểu rõ dữ liệu của chính mình.
Với cộng đồng developer Việt Nam, tôi khuyên các bạn đừng bỏ qua bước này. Một mô hình tốt không chỉ nằm ở thuật toán, mà còn ở cách bạn xử lý, biến đổi dữ liệu ban đầu. Hãy xem phân loại là nghệ thuật, là cầu nối giúp biến dữ liệu thô thành các lớp rủi ro rõ ràng, từ đó nâng cao độ tin cậy của các dự án AI, tài chính của chúng ta.