Transformer: Kiến trúc mạng nơ-ron đang định hình tương lai trí tuệ nhân tạo
AI Summary
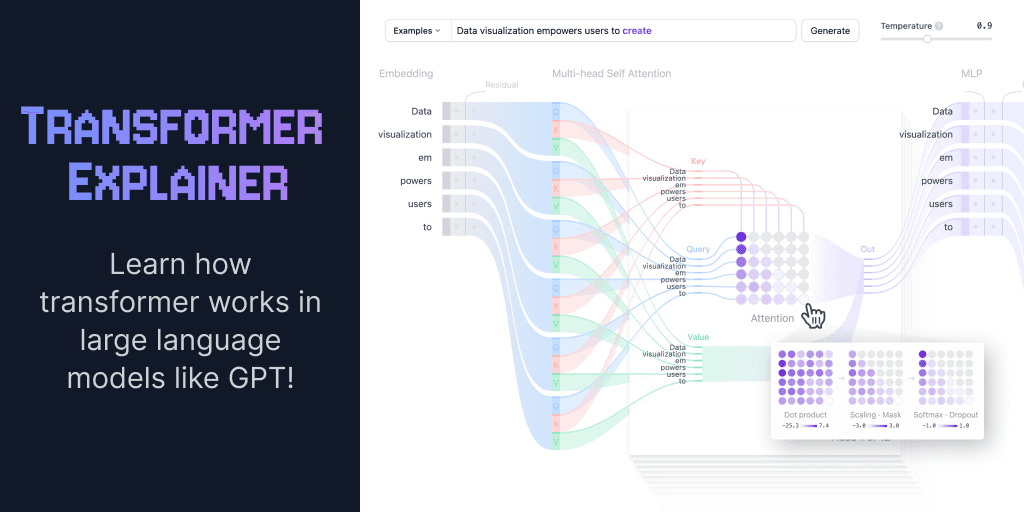
Điểm nổi bật của Transformer nằm ở cơ chế tự chú ý (self-attention). Trước đây, các mô hình AI như LSTM hay GRU gặp khó khăn trong việc xử lý các chuỗi dữ liệu dài, bởi chúng bị giới hạn bởi khả năng ghi nhớ ngữ cảnh. Trong khi đó, Transformer cho phép mô hình xử lý toàn bộ chuỗi dữ liệu cùng lúc, thay vì phải tuần tự qua từng bước. Điều này giúp nó nắm bắt được các mối quan hệ dài hạn giữa các từ hoặc các phần tử trong chuỗi, từ đó cải thiện đáng kể độ chính xác và hiệu quả xử lý.
Cốt lõi của Transformer là khả năng dự đoán từ tiếp theo trong một chuỗi văn bản. Khi người dùng nhập vào một đoạn văn bản, Transformer sẽ phân tích và tính toán xác suất để xác định từ hoặc cụm từ có khả năng xuất hiện tiếp theo. Đây chính là nguyên lý hoạt động của các mô hình ngôn ngữ như GPT-2, GPT-3 hay GPT-4, vốn đã trở thành nền tảng cho các ứng dụng như ChatGPT của OpenAI hay Llama của Meta. Những mô hình này không chỉ dừng lại ở việc tạo ra văn bản tự nhiên mà còn có thể trả lời câu hỏi, viết mã lập trình, hay thậm chí sáng tác thơ và nhạc.
Một Transformer điển hình bao gồm ba thành phần chính: Embedding, các khối Transformer (Transformer blocks), và lớp đầu ra. Đầu tiên, văn bản đầu vào được chia nhỏ thành các đơn vị gọi là token, có thể là từ hoặc các phần của từ. Các token này sau đó được chuyển đổi thành các vector số thông qua quá trình embedding, trong đó mỗi vector đại diện cho ý nghĩa ngữ nghĩa của token tương ứng. Đây là bước đầu tiên để mô hình có thể xử lý dữ liệu văn bản dưới dạng số học.
Tiếp theo, các vector embedding được đưa qua các khối Transformer. Mỗi khối Transformer bao gồm hai thành phần chính: cơ chế tự chú ý và lớp MLP (Multilayer Perceptron). Cơ chế tự chú ý cho phép mỗi token trong chuỗi dữ liệu "giao tiếp" với tất cả các token khác, từ đó hiểu được ngữ cảnh tổng thể. Ví dụ, trong câu "Con mèo nhảy qua hàng rào vì nó đói", cơ chế này giúp mô hình nhận ra rằng từ "nó" liên quan đến "con mèo", chứ không phải "hàng rào". Trong khi đó, lớp MLP hoạt động như một mạng nơ-ron truyền thống, xử lý từng token một cách độc lập để tăng cường khả năng biểu diễn của mô hình.
Một điểm đáng chú ý khác là khả năng mở rộng của Transformer. Các mô hình như GPT-2, với 124 triệu tham số, chỉ là phiên bản nhỏ gọn so với GPT-3 (175 tỷ tham số) hay GPT-4. Tuy nhiên, tất cả các mô hình này đều dựa trên cùng một kiến trúc cơ bản, cho thấy sự linh hoạt và mạnh mẽ của Transformer trong việc xử lý các bài toán phức tạp.
Không chỉ dừng lại ở lĩnh vực xử lý ngôn ngữ tự nhiên, Transformer còn được ứng dụng rộng rãi trong nhiều lĩnh vực khác. Trong nhận diện hình ảnh, các mô hình như Vision Transformer (ViT) đã chứng minh rằng cơ chế tự chú ý có thể thay thế các mạng nơ-ron tích chập (CNN) truyền thống để phân tích hình ảnh. Trong sinh học, công nghệ này đã được sử dụng để dự đoán cấu trúc protein, một bài toán quan trọng trong nghiên cứu y học. Ngoài ra, các mô hình Transformer cũng đã được áp dụng thành công trong các trò chơi điện tử, nơi chúng có thể học cách chơi và tối ưu hóa chiến lược.
Dù vậy, Transformer không phải không có những thách thức. Một trong những vấn đề lớn nhất là chi phí tính toán. Với số lượng tham số khổng lồ, các mô hình như GPT-3 hay GPT-4 yêu cầu một lượng tài nguyên tính toán và năng lượng rất lớn, gây ra những lo ngại về tính bền vững và tác động đến môi trường. Bên cạnh đó, các mô hình này cũng đối mặt với vấn đề đạo đức và trách nhiệm, khi chúng có thể bị lạm dụng để tạo ra thông tin sai lệch hoặc nội dung độc hại.
Tuy nhiên, không thể phủ nhận rằng Transformer đã mở ra một kỷ nguyên mới cho trí tuệ nhân tạo. Với khả năng xử lý dữ liệu vượt trội và tính linh hoạt cao, nó đã trở thành nền tảng cho nhiều ứng dụng công nghệ tiên tiến. Khi các nhà nghiên cứu tiếp tục cải tiến và tối ưu hóa kiến trúc này, chúng ta có thể kỳ vọng vào những bước đột phá mới, không chỉ trong lĩnh vực công nghệ mà còn trong các ngành khoa học và công nghiệp khác.