Qwen 3.8 27B: Sức mạnh ấn tượng nhưng dễ sa vào tình trạng 'suy nghĩ quá nhiều'
AI Summary
Qwen 3.8 27B: Một bước tiến lớn trong lĩnh vực mô hình AI
Ngày 16 tháng 8 năm 2026, Alibaba chính thức ra mắt Qwen 3.8 27B, một mô hình ngôn ngữ lớn (LLM) với 27 tỷ tham số, được cấp phép theo Apache 2. Đây là một trong những sản phẩm nổi bật từ phòng nghiên cứu Qwen của Alibaba, tiếp nối thành công của các phiên bản trước như Qwen 3.6 27B và Qwen 3.7-Plus. Với kích thước 27B, Qwen 3.8 không chỉ mạnh mẽ mà còn phù hợp để chạy trên các thiết bị có cấu hình vừa phải, mở ra khả năng ứng dụng rộng rãi hơn trong cộng đồng nghiên cứu và phát triển AI.
Theo các số liệu tự báo cáo từ nhóm nghiên cứu, Qwen 3.8 27B đạt được những cải thiện đáng kể về hiệu suất so với các phiên bản trước. Đặc biệt, nó vượt qua cả Qwen 3.7-Plus, một trong những mô hình mạnh nhất của Qwen tính đến tháng 5 năm nay. Điều này khiến giới công nghệ không khỏi tò mò về kết quả từ các thử nghiệm độc lập, vốn sẽ là thước đo khách quan hơn để đánh giá năng lực thực sự của mô hình.
Tác giả Simon Willison đã thử nghiệm Qwen 3.8 trên hai hệ thống khác nhau: một chiếc MacBook Pro M5 Max với RAM 128GB và một máy NVIDIA DGX Spark. Trên cả hai nền tảng, ông sử dụng LM Studio với phiên bản Q4_K_M đã được lượng tử hóa (quantized) để giảm dung lượng xuống còn 17GB. Ngoài ra, ông cũng thử nghiệm chạy trực tiếp qua llama-server trên nền tảng DGX Spark. Những trải nghiệm này đã mang lại nhiều phát hiện thú vị, đặc biệt về cách Qwen xử lý các tác vụ phức tạp.
Khi mô hình 'suy nghĩ quá mức' trở thành vấn đề
Một trong những điểm đặc biệt của Qwen 3.8 là khả năng điều chỉnh mức độ "nỗ lực suy luận" (reasoning effort) thông qua các thiết lập: xhigh (cao nhất), medium (trung bình) và low (thấp). Theo tài liệu chính thức, mức xhigh được mặc định nhằm phục vụ các tác vụ đòi hỏi phân tích chuyên sâu. Tuy nhiên, đây lại là một lựa chọn gây tranh cãi khi áp dụng trên phần cứng tiêu dùng thông thường.
Simon Willison nhận thấy rằng thiết lập mặc định này dẫn đến tình trạng "suy nghĩ quá mức" ngay cả với các vấn đề đơn giản. Ví dụ, khi sử dụng LM Studio với giới hạn ngữ cảnh mặc định là 8.192 token, Qwen nhanh chóng tiêu tốn toàn bộ dung lượng này chỉ để phân tích những nhiệm vụ không quá phức tạp. Sau khi tăng giới hạn lên mức tối đa 262.144 token, vấn đề này được giải quyết, nhưng cái giá phải trả là thời gian xử lý kéo dài đáng kể.
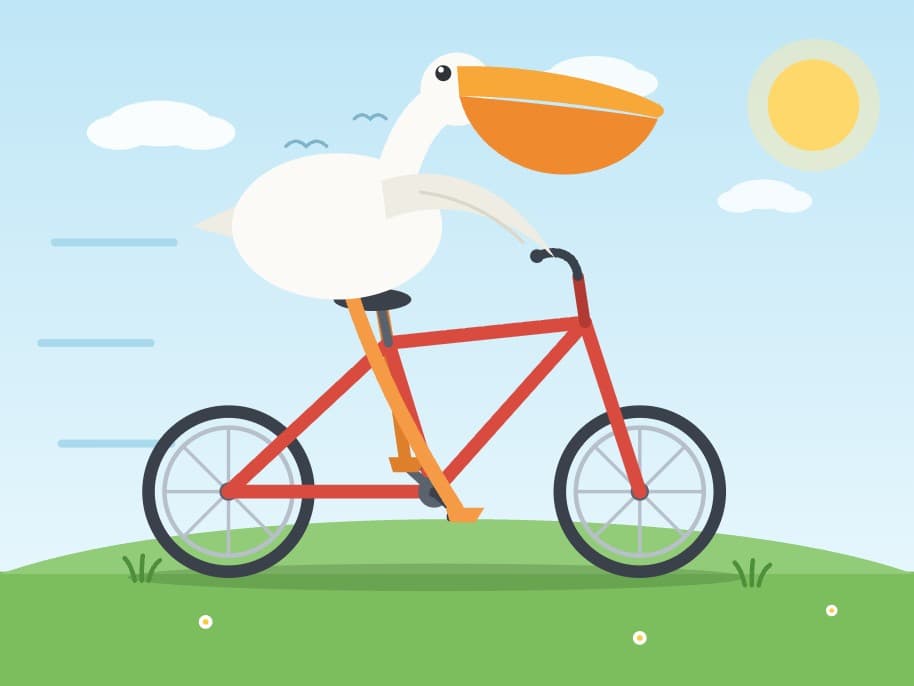
Một minh chứng cụ thể là khi Simon yêu cầu Qwen tạo một hình SVG về "một con bồ nông đang cưỡi xe đạp". Với thiết lập ngữ cảnh mở rộng, mô hình đã sử dụng tới 22.276 token để suy luận và tạo ra 3.223 token đầu ra. Quá trình này tiêu tốn 21 phút để hoàn thành. Kết quả là một hình ảnh SVG với khung xe đạp được thiết kế chính xác và đôi chân của con bồ nông được đặt đúng vị trí. Đây là một thành tựu đáng chú ý khi xét đến việc mô hình chỉ chiếm 17GB dung lượng trên đĩa cứng. Tuy nhiên, thời gian xử lý kéo dài và lượng tài nguyên tiêu thụ cho một tác vụ giải trí đơn giản như vậy đặt ra câu hỏi về tính hiệu quả của thiết lập mặc định "xhigh".
Hiệu năng và tiềm năng ứng dụng
Dù gặp phải vấn đề "suy nghĩ quá mức", Qwen 3.8 vẫn được đánh giá cao về khả năng xử lý các tác vụ phức tạp. Với dung lượng nhỏ gọn và khả năng chạy trên các thiết bị tiêu chuẩn, mô hình này mở ra cơ hội lớn cho các nhà phát triển muốn tận dụng sức mạnh AI mà không cần đầu tư vào hạ tầng quá đắt đỏ. Đặc biệt, việc hỗ trợ ngữ cảnh dài lên đến 262.144 token là một điểm cộng lớn, cho phép mô hình xử lý các tài liệu dài hoặc các bài toán yêu cầu phân tích dữ liệu phức tạp.
Tuy nhiên, để tối ưu hóa hiệu suất, người dùng cần cân nhắc điều chỉnh mức độ "nỗ lực suy luận" phù hợp với từng loại tác vụ. Với các bài toán đơn giản, thiết lập "medium" hoặc "low" có thể là lựa chọn hợp lý hơn, vừa tiết kiệm thời gian vừa giảm chi phí tính toán. Trong khi đó, mức "xhigh" nên được dành cho các bài toán thực sự phức tạp, nơi mà độ chính xác và phân tích sâu là yếu tố then chốt.
Với những cải tiến vượt bậc và tiềm năng ứng dụng rộng rãi, Qwen 3.8 27B không chỉ là một bước tiến lớn trong lĩnh vực AI mà còn đặt ra những thách thức mới về cách tối ưu hóa và sử dụng mô hình một cách hiệu quả. Liệu các phiên bản tiếp theo có thể giải quyết triệt để vấn đề "suy nghĩ quá mức" mà vẫn giữ được sức mạnh vượt trội? Đây sẽ là điều mà cộng đồng công nghệ tiếp tục theo dõi trong thời gian tới.