Hybrid Search và Re-Ranking trong Production RAG: Bí quyết tối ưu hóa tìm kiếm thông minh
AI Summary
Khi semantic search không đủ để làm chủ cuộc chơi
Trong lĩnh vực AI và tìm kiếm thông minh, các mô hình Large Language Models (LLMs) như GPT hay BERT đã giúp chúng ta xây dựng các hệ thống truy vấn dựa trên ý nghĩa (semantic search). Tuy nhiên, như mọi thứ đều có giới hạn, việc dựa hoàn toàn vào dense retrieval – tức là tìm kiếm dựa trên vector nhúng – đôi khi không đủ để đáp ứng các yêu cầu chính xác cao trong môi trường sản xuất.
Ví dụ thực tế là câu chuyện của chúng tôi về một trợ lý nội bộ trả lời sai lệch về chính sách retry của message queue. Dù hệ thống đã lấy được tài liệu đúng, nhưng do xếp hạng không chính xác, tài liệu quan trọng nằm ngoài top kết quả. Điều này phản ánh rõ ràng rằng, trong nhiều tình huống, chúng ta cần thêm các chiến lược để lọc và xếp hạng lại kết quả, chứ không chỉ dừng lại ở việc tìm kiếm dựa trên vector.
Tại sao dense retrieval vẫn chưa đủ
Dense retrieval hoạt động bằng cách chuyển đổi đoạn văn bản thành vector có độ phân giải cao, sau đó so sánh khoảng cách cosine để tìm các đoạn phù hợp. Điều này rất hiệu quả cho các truy vấn mang tính khái quát hoặc conceptual, như hỏi về quy trình xử lý sự cố hoặc các thuật ngữ chung chung.
Tuy nhiên, khi bạn cần tìm chính xác một thuật ngữ kỹ thuật, như “dead-letter queue threshold”, thì mô hình nhúng có thể bị “lười biếng”. Khi các từ ngữ xung quanh trong câu được trọng số hóa, nó có thể làm mất đi độ chính xác của từ khóa chính xác mà bạn cần. Thậm chí, một đoạn văn bản dài với nhiều ý nghĩa có thể “làm loãng” từ khóa cụ thể trong vector nhúng, khiến hệ thống bỏ qua những tài liệu quan trọng này.
Ví dụ đơn giản: Thay vì tìm đúng “dead-letter queue threshold”, hệ thống có thể lấy ra những tài liệu nói về “queue” hoặc “threshold” chung chung, nhưng không đúng mục đích chính xác bạn cần. Điều này dẫn đến câu chuyện của chúng ta: hệ thống trả lời đúng về mặt kiến thức chung, nhưng sai về mặt kỹ thuật cụ thể.
Kết hợp giữa tìm kiếm semantic và traditional: hybrid search
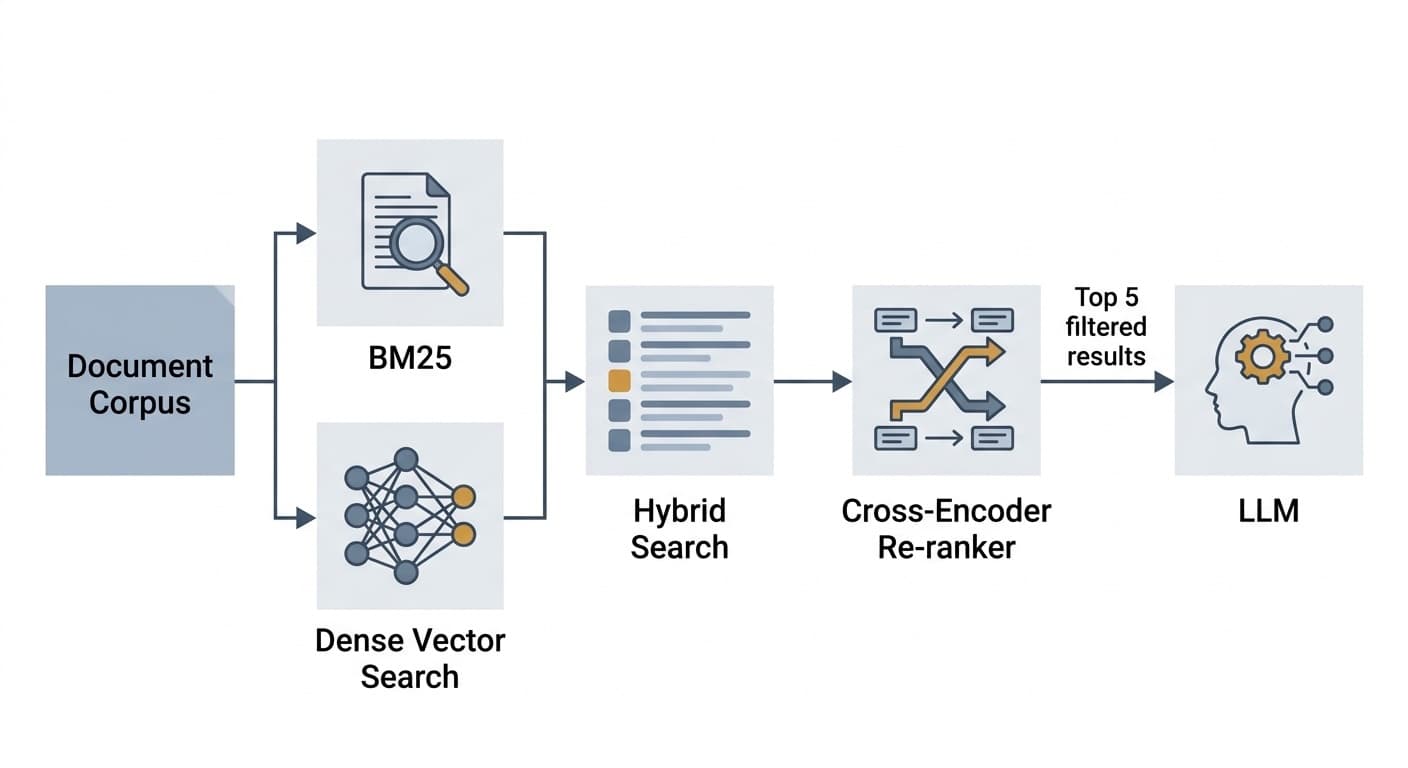
Giải pháp tối ưu cho bài toán này chính là hybrid search – kết hợp giữa semantic search và các phương pháp truyền thống như BM25 hay TF-IDF. Trong đó, BM25 là một thuật toán dựa trên xác suất, giúp xếp hạng tài liệu dựa trên tần suất xuất hiện của từ khóa trong câu hỏi và tài liệu.
Trong thực tế, chúng ta sẽ dùng semantic search để lọc ra danh sách các tài liệu phù hợp về mặt ý nghĩa, rồi sau đó áp dụng re-ranking bằng các mô hình dựa trên cross-encoder hoặc các kỹ thuật học có giám sát để xác định chính xác hơn tài liệu phù hợp nhất. Kết quả là, ta không chỉ dựa vào ý nghĩa chung chung, mà còn dựa vào các chỉ số chính xác của từ khóa.
Re-ranking: nâng tầm chính xác của hệ thống
Re-ranking là bước quan trọng giúp hệ thống phân biệt rõ ràng đâu mới là tài liệu đúng nhất. Một cross-encoder, ví dụ, sẽ đánh giá từng cặp câu hỏi – tài liệu để xác định độ phù hợp chính xác dựa trên nội dung toàn diện của chúng.
Trong thực tế, bạn có thể xây dựng một mô hình cross-encoder đơn giản bằng cách fine-tune trên bộ dữ liệu gồm các câu hỏi và các tài liệu phù hợp hoặc không phù hợp. Khi đó, sau khi có danh sách lọc sơ bộ từ semantic search và BM25, hệ thống sẽ đánh giá từng tài liệu theo cặp và sắp xếp lại dựa trên điểm số phù hợp.
Dưới góc nhìn của developer Việt, việc implement một hệ thống re-ranking không quá phức tạp, nhưng yêu cầu sự hiểu biết về các mô hình neural network nâng cao và tối ưu hiệu năng để xử lý lượng dữ liệu lớn trong thời gian thực.
Đánh giá tác động và kết luận
Việc kết hợp hybrid search và re-ranking đã chứng minh rõ ràng khả năng nâng cao độ chính xác và trải nghiệm người dùng trong các hệ thống tìm kiếm nội bộ, chatbot doanh nghiệp, hoặc trợ lý ảo. Với các hệ thống nội bộ của doanh nghiệp Việt, đặc biệt là các ứng dụng kỹ thuật hoặc quản trị, chiến lược này giúp giảm thiểu sai sót, nâng cao tính chính xác của thông tin cung cấp.
Tuy nhiên, không có giải pháp nào hoàn hảo 100%. Việc tinh chỉnh các mô hình, lựa chọn các thuật toán phù hợp, và tối ưu performance luôn là bài toán dài hơi, cần sự đầu tư và nghiên cứu liên tục.
Lời khuyên của tôi dành cho các developer Việt là hãy bắt đầu từ các mô hình đơn giản, hiểu rõ dữ liệu của mình, rồi từ đó nâng cấp dần các bước phức tạp hơn như re-ranking. Công nghệ AI không phải là thứ xa vời, mà là công cụ giúp chúng ta làm việc hiệu quả hơn, miễn là chúng ta biết cách khai thác đúng cách và phù hợp với từng bài toán cụ thể.