DFSX của Trung Quốc vượt mặt NVIDIA với băng thông bộ nhớ gấp đôi nhờ kiến trúc 14nm đột phá
AI Summary
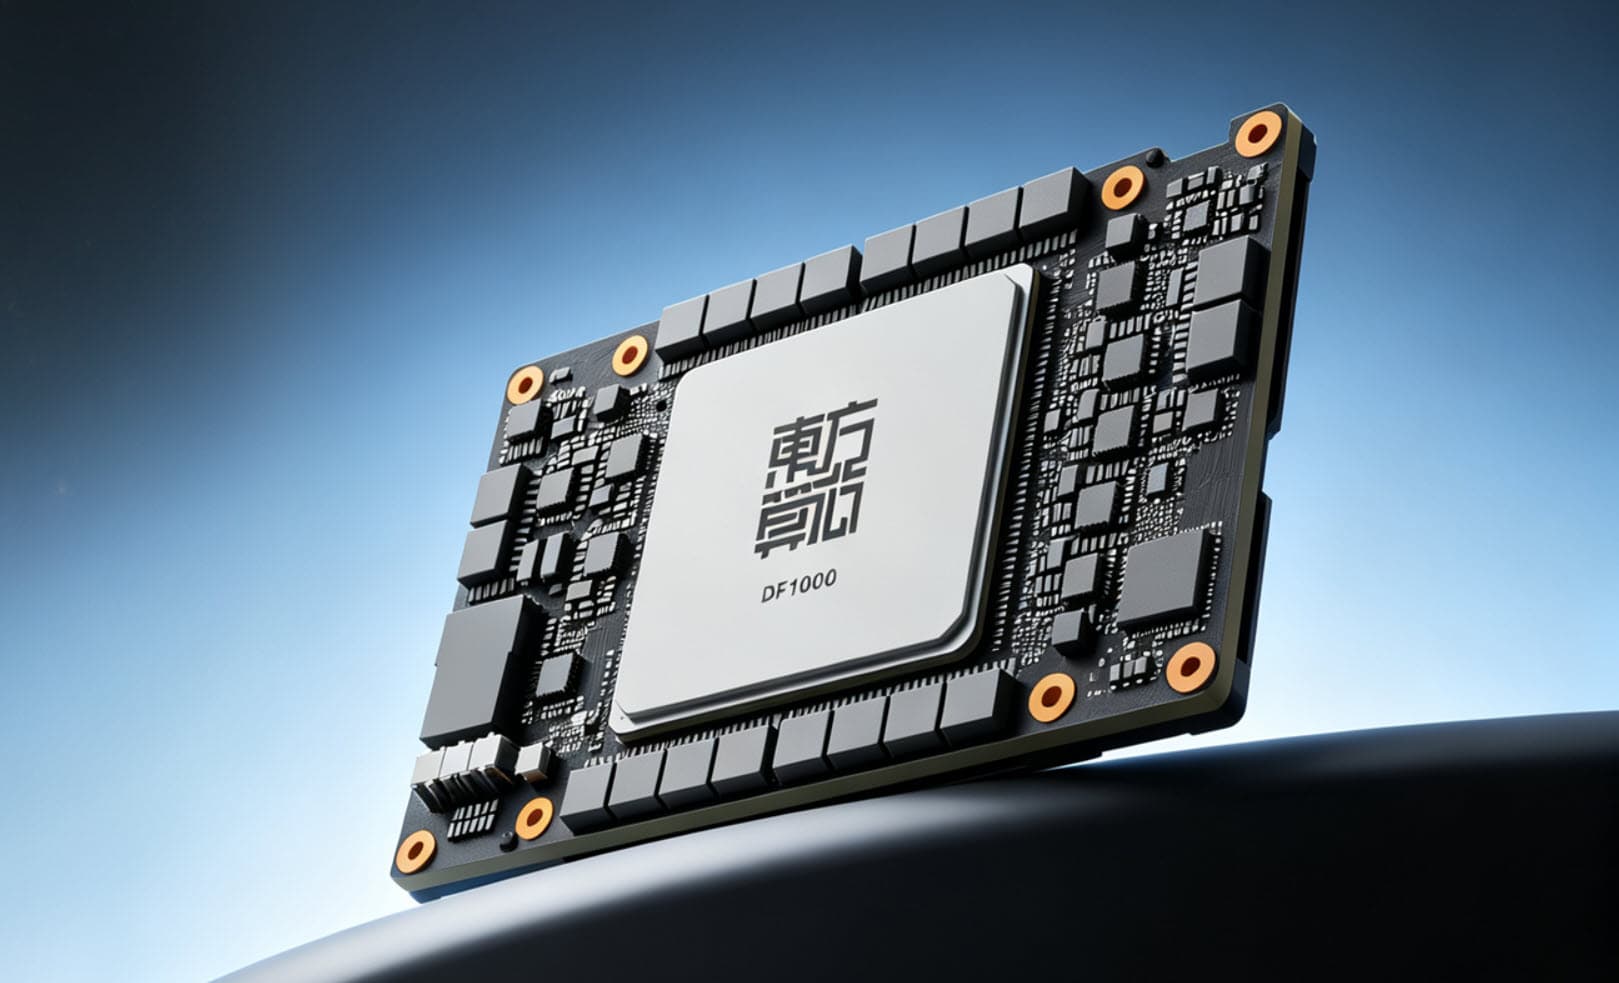
DFSX đã giới thiệu hệ thống TY64 SuperNode, được xây dựng từ các chip DF2000 sử dụng tiến trình 14nm. Một con số đáng kinh ngạc là hệ thống này đạt băng thông bộ nhớ lên tới 960TB/s, vượt xa mức 576TB/s của NVIDIA GB200 NVL72. Điều này không chỉ đơn thuần là một bước nhảy vọt về thông số kỹ thuật, mà còn là minh chứng cho sự thay đổi trong cách tiếp cận thiết kế chip. Thay vì tập trung vào việc thu nhỏ kích thước tiến trình, DFSX đã chọn cách tối ưu hóa cấu trúc và tận dụng những công nghệ tiên tiến như liên kết lai wafer 3D.
Một trong những điểm đột phá lớn nhất của DFSX nằm ở việc loại bỏ hoàn toàn microbumps trong thiết kế. Thay vào đó, công ty sử dụng kiến trúc tính toán gần bộ nhớ 3D (3D near-memory compute architecture), trong đó bộ nhớ được xếp chồng trực tiếp lên lớp tính toán và kết nối thông qua công nghệ liên kết lai wafer 3D. Phương pháp này không chỉ giúp giảm thiểu độ trễ mà còn tăng cường đáng kể hiệu suất truyền tải dữ liệu giữa các lớp. Việc loại bỏ microbumps – vốn là một thành phần quan trọng trong các thiết kế truyền thống – không chỉ giảm chi phí sản xuất mà còn cải thiện độ tin cậy của hệ thống, khi loại bỏ được các vấn đề liên quan đến nhiệt và điện trở.
Trong khi ngành công nghiệp bán dẫn toàn cầu vẫn đang tập trung vào việc phát triển các tiến trình nhỏ hơn như 5nm hay 3nm, DFSX đã chứng minh rằng tiến trình 14nm vẫn có thể đạt được những thành tựu đáng kể nếu được tối ưu hóa đúng cách. Điều này đặc biệt quan trọng trong bối cảnh các công ty lớn như TSMC và Samsung đang gặp khó khăn trong việc cải thiện năng suất sản xuất ở các tiến trình tiên tiến hơn. DFSX đã chọn một hướng đi khác biệt, tập trung vào việc tối ưu hóa băng thông bộ nhớ – yếu tố ngày càng trở nên quan trọng trong các ứng dụng trí tuệ nhân tạo (AI) và học sâu (deep learning).
Các ứng dụng AI hiện đại yêu cầu khả năng xử lý dữ liệu khổng lồ trong thời gian ngắn, và băng thông bộ nhớ trở thành một yếu tố quyết định. Trong khi các giải pháp của NVIDIA vẫn dựa vào kiến trúc truyền thống với các hạn chế về băng thông, DFSX đã tận dụng lợi thế của công nghệ 3D để vượt qua những giới hạn này. Bằng cách xếp chồng bộ nhớ và các lớp tính toán theo chiều dọc, DFSX không chỉ tăng cường hiệu suất mà còn giảm thiểu không gian vật lý cần thiết, mở ra tiềm năng mới cho các thiết kế chip trong tương lai.
Tuy nhiên, sự đổi mới của DFSX không chỉ dừng lại ở khía cạnh kỹ thuật. Việc sử dụng tiến trình 14nm – một công nghệ đã được thương mại hóa rộng rãi và có chi phí sản xuất thấp – giúp DFSX đạt được lợi thế kinh tế đáng kể. Trong khi các đối thủ phải đầu tư hàng tỷ USD để phát triển và sản xuất ở các tiến trình tiên tiến hơn, DFSX có thể tận dụng cơ sở hạ tầng hiện có để giảm chi phí và tăng khả năng cạnh tranh. Điều này đặc biệt quan trọng trong bối cảnh thị trường AI đang phát triển nhanh chóng và yêu cầu các giải pháp có hiệu suất cao nhưng vẫn đảm bảo chi phí hợp lý.
Nhìn vào bức tranh tổng thể, sự xuất hiện của DFSX với các sản phẩm như DF2000 và TY64 SuperNode không chỉ là một thách thức đối với các ông lớn trong ngành công nghệ như NVIDIA, mà còn là một lời nhắc nhở rằng sự đổi mới không nhất thiết phải gắn liền với các tiến trình nhỏ hơn. Thay vào đó, việc tối ưu hóa kiến trúc và tập trung vào các yếu tố cốt lõi như băng thông bộ nhớ có thể mang lại những bước tiến vượt bậc. Với những thành tựu này, DFSX đang định hình lại cách mà ngành công nghiệp bán dẫn tiếp cận các thách thức trong kỷ nguyên AI, đồng thời mở ra những khả năng mới cho tương lai của công nghệ tính toán hiệu năng cao.